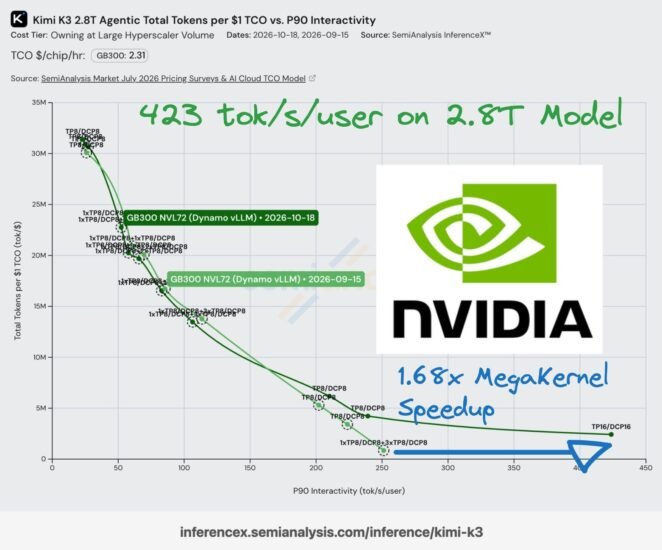


英伟达优化 Kimi K3 推理速度
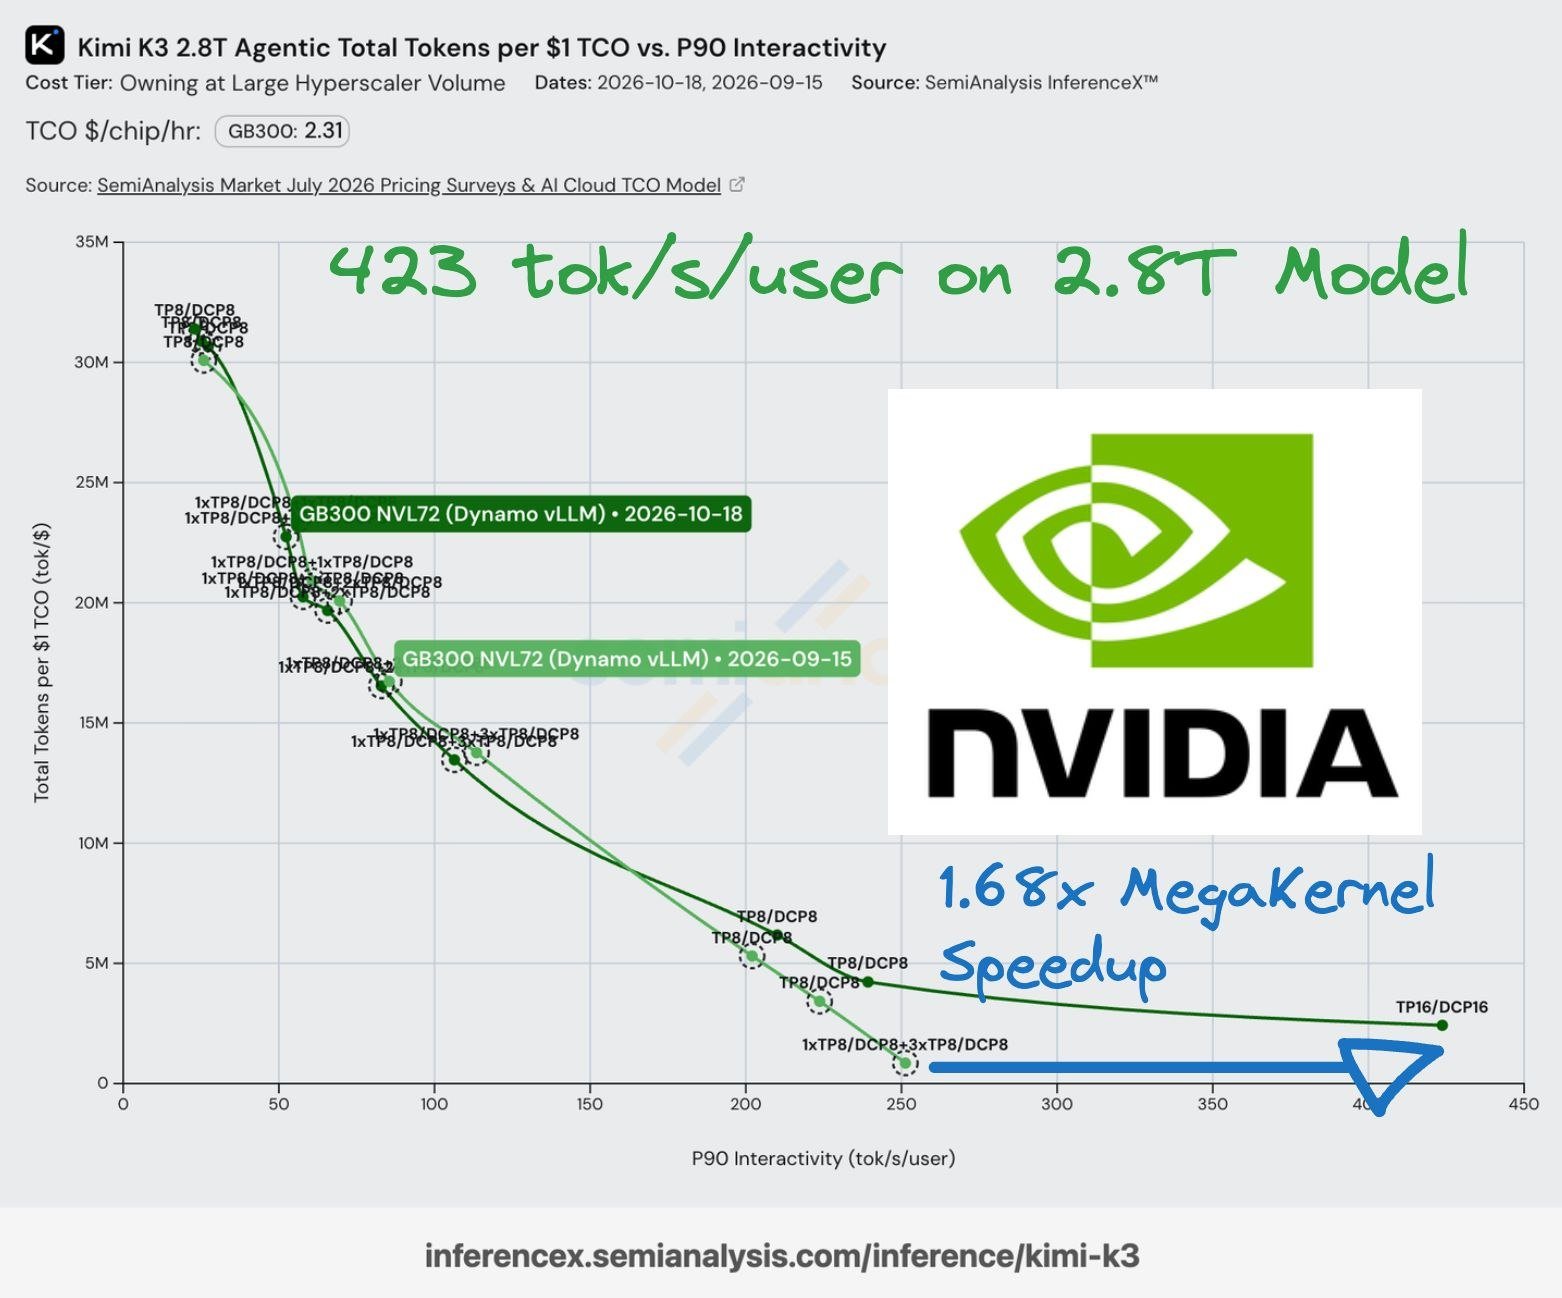
SemiAnalysis 发文称,英伟达通过一项上游 vLLM 优化,在 2.8 万亿参数的 Kimi K3 模型上实现每用户每秒 423 个 token 的速度,相同硬件下快 1.68 倍。
该帖称,英伟达 CentML 的 Benjamin 使用 Cute DSL 编写了解码专用内核,并通过 Megakernel 融合实现优化;英伟达也在为 vLLM 开发适配 DeepSeek v4.1 等模型的工作。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END


暂无评论内容