

百度开源基座模型文心 5.5 Flash Base
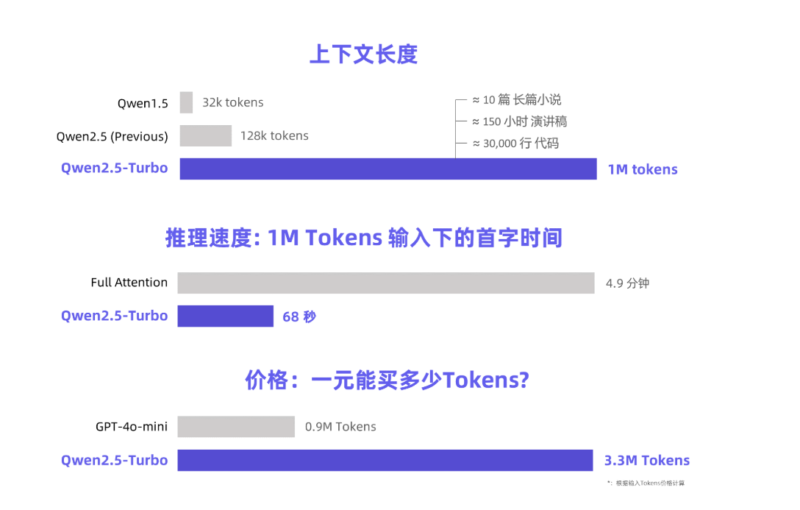
百度正式开源最新基座模型文心 5.5 Flash Base。模型采用 MoE 架构,总参数量 2800 亿,每 Token 激活 140 亿参数,预训练用 33.5 万亿 Token,预训练上下文最长 128K,微调与推理支持最长 100 万 Token 上下文。
围绕“效率”主线,模型在注意力机制、专家路由及训练目标等环节做了系统性优化,以提升资源利用效率。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
百度开源基座模型文心 5.5 Flash Base
百度正式开源最新基座模型文心 5.5 Flash Base。模型采用 MoE 架构,总参数量 2800 亿,每 Token 激活 140 亿参数,预训练用 33.5 万亿 Token,预训练上下文最长 128K,微调与推理支持最长 100 万 Token 上下文。
围绕“效率”主线,模型在注意力机制、专家路由及训练目标等环节做了系统性优化,以提升资源利用效率。


暂无评论内容