AI“分词器税”可使部分语言使用成本最高相差 17 倍

AI“分词器税”可使部分语言使用成本最高相差 17 倍

AI“分词器税”可使部分语言使用成本最高相差 17 倍

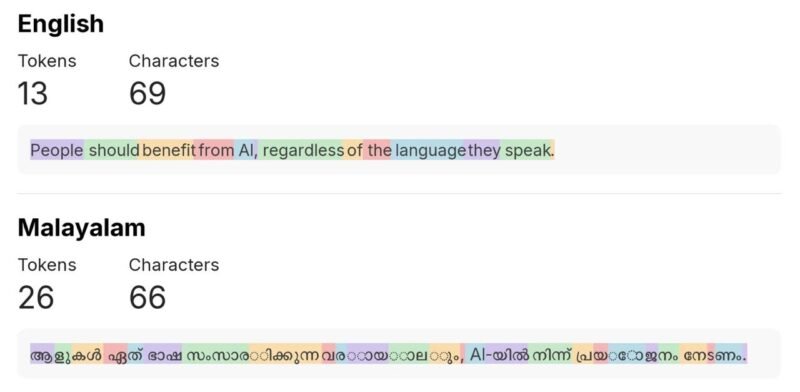
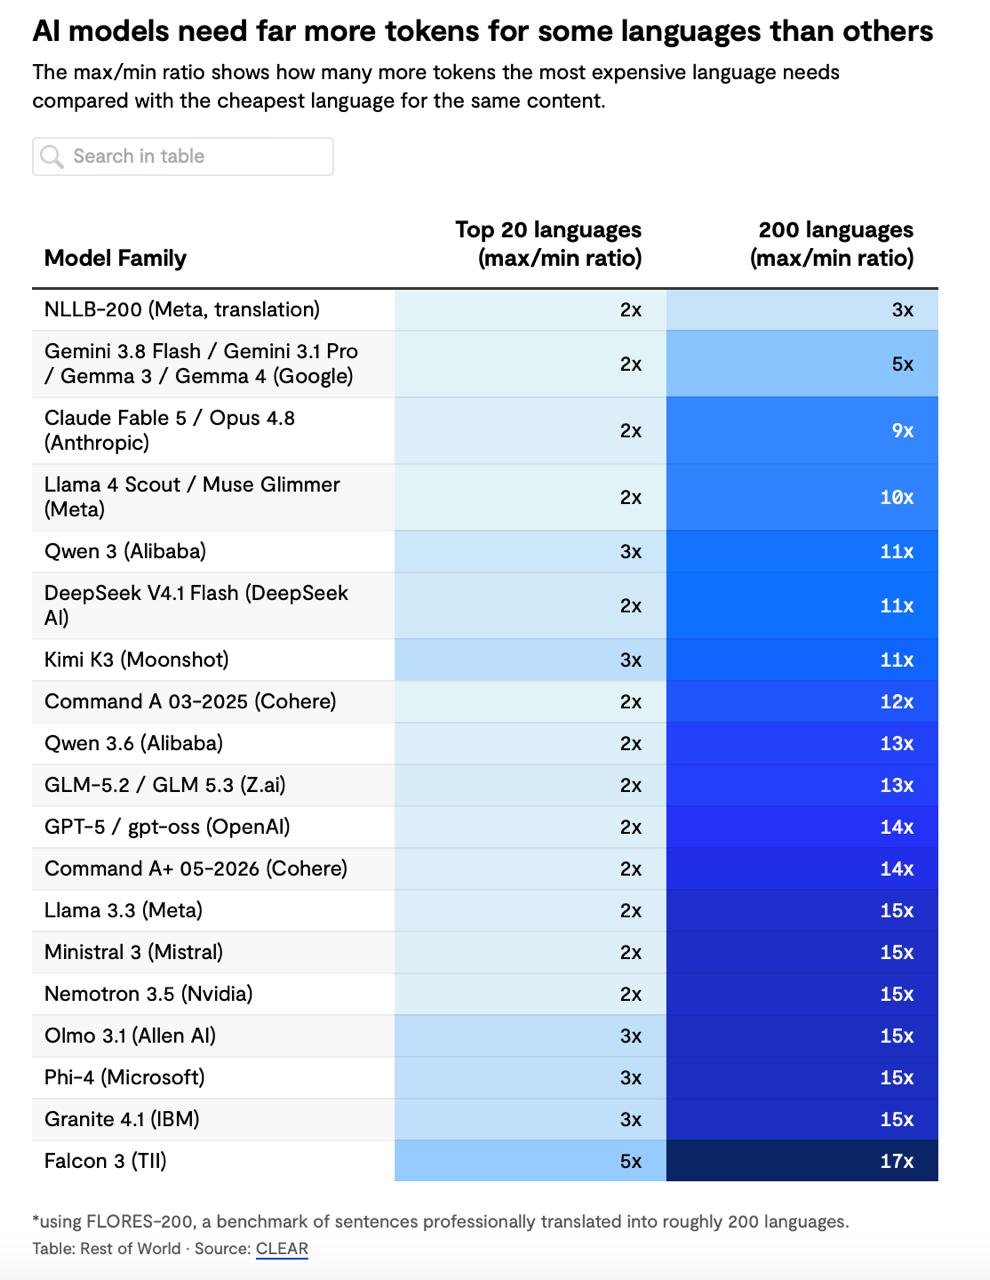
CLEAR 研究联盟发布报告指出,主流 AI 模型的分词器对英语及高资源语言优化明显,导致部分非英语语言处理相同内容时消耗更多 Token。例如,同一句话英语需要 13 个 Token,马拉雅拉姆语需要 26 个,阿姆哈拉语则高达 78 个。研究覆盖约 200 种语言,发现不同语言的 Token 消耗差距最高达 17 倍。这不仅推高用户使用成本,还会增加响应延迟、压缩有效上下文容量。
Rest of World | Clear

🌸 科技圈· 茶馆 · 投稿

配图

© 版权声明
THE END
喜欢就支持一下吧
点赞7 分享
评论 抢沙发
头像
欢迎您留下宝贵的见解!
提交
头像

昵称

取消
昵称表情代码图片快捷回复

    暂无评论内容

免责声明:

本站所有内容和资源均来自网络,仅供用户交流、学习与研究使用。版权归原版权方所有,本站不承担任何版权争议责任。

用户下载后不得用于商业或非法用途,需在24小时内从电脑中删除,否则责任自负。

访问和下载文件即表示您同意仅将其用于参考和学习,其他用途后果自负。

如您喜欢该程序,请支持正版软件,购买注册以获得更好的服务。

本站为非营利性个人网站,所有软件信息来自网络,仅供学习和研究参考,无商业用途。会员捐赠仅用于支持服务器的维护,完全自愿。